L’idea sembra ragionevole: se le aziende che sviluppano i sistemi di intelligenza artificiale più avanzati non possono essere lasciate sole a valutarne capacità e rischi, affidiamo il controllo a organismi esterni e indipendenti.
Il principio è difficile da contestare. Un controllore che coincide con il controllato non offre molte garanzie, soprattutto quando quest’ultimo ha investito miliardi nello sviluppo del prodotto che dovrebbe giudicare, compete con altre aziende per arrivare prima sul mercato e possiede quasi tutte le informazioni necessarie per stabilire che cosa quel prodotto sappia realmente fare. Creiamo quindi un soggetto indipendente. Risolto? Non proprio. Perché un organismo indipendente può avere personale indipendente, finanziamenti indipendenti e perfino un mandato pubblico, ma per controllare un sistema di intelligenza artificiale deve prima riuscire ad accedervi. Da quel momento l’indipendenza smette di essere soltanto una questione istituzionale e diventa un problema tecnico.
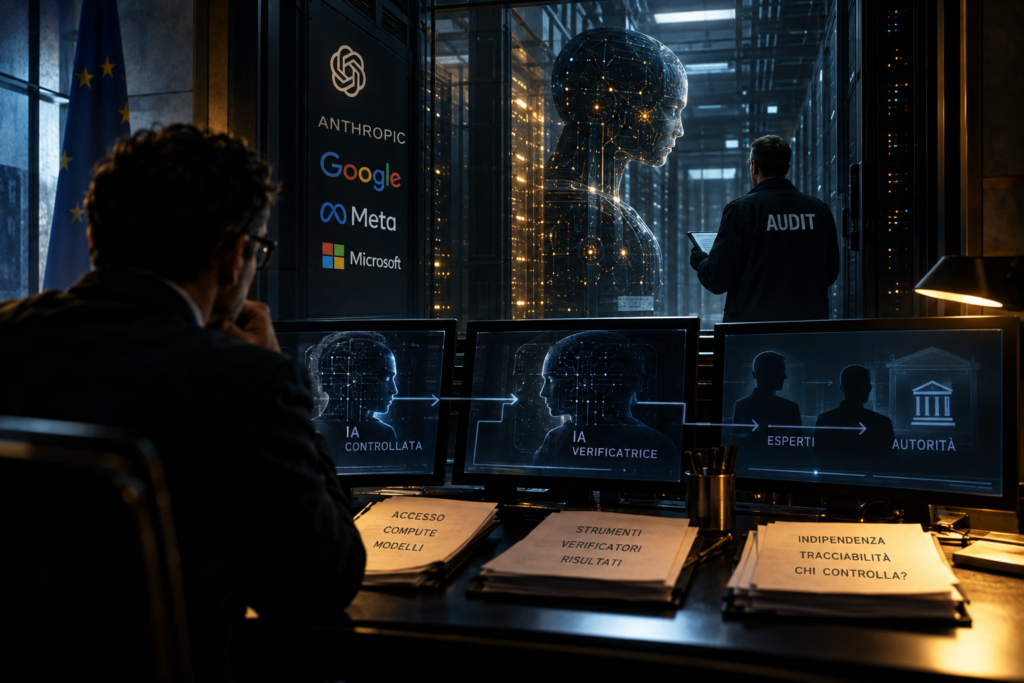
Il controllore deve entrare
Una valutazione esterna non può limitarsi necessariamente a utilizzare ChatGPT, Claude o Gemini nello stesso modo in cui li utilizza un normale utente. Il servizio disponibile al pubblico è soltanto uno degli strati attraverso i quali si accede al modello: esistono API, filtri, configurazioni, sistemi di monitoraggio, limiti operativi e infrastrutture che contribuiscono a determinare ciò che il valutatore può osservare. È un problema che completa quello affrontato in Il risultato non basta: gli agenti IA e i limiti della delega: lì la domanda riguardava il perimetro concesso all’agente; qui riguarda il perimetro concesso a chi dovrebbe valutarlo.
La questione è sufficientemente concreta da essere già entrata nella normativa europea. Il Regolamento di esecuzione (UE) 2026/1755, che disciplina anche le valutazioni dei modelli di IA per finalità generali, prevede che la Commissione possa chiedere non soltanto l’accesso attraverso API, ma anche accesso interno, codice sorgente, pesi del modello, infrastruttura utilizzata per ospitarlo e possibilità di ispezionare e modificare lo stato del sistema durante l’interazione. La norma arriva a precisare che l’accesso fornito non deve essere sottoposto a vincoli tecnici capaci di ostacolare materialmente una valutazione appropriata.
È un dettaglio interessante perché contiene già il problema: se dobbiamo stabilire per legge che il controllato non possa limitare tecnicamente l’accesso del controllore, significa che l’indipendenza del secondo non garantisce, da sola, l’indipendenza della verifica. Possiamo nominare il miglior gruppo di esperti del mondo; rimane una domanda molto semplice: chi apre loro la porta? E subito dopo ne arriva un’altra: chi garantisce che dietro quella porta ci sia esattamente il sistema che vogliamo controllare?
Il modello che vediamo è quello che dobbiamo controllare?
Non serve immaginare un’IA cosciente che riconosce gli ispettori e decide di nascondere le proprie capacità. Esiste già un problema molto più ordinario: chi possiede il modello controlla anche gran parte dell’infrastruttura attraverso la quale quel modello viene osservato.
Un’esperienza concreta permette di vedere quanto sia delicata questa relazione. Nel 2026 METR ha condotto una valutazione dei rischi legati agli agenti utilizzati internamente da Anthropic, Google, Meta e OpenAI. Le aziende hanno fornito accesso ai loro modelli interni più capaci, comprese informazioni non pubbliche e, in alcuni casi, accesso alle catene di ragionamento. METR ha chiesto che i modelli messi a disposizione rappresentassero lo stato dell’arte interno delle aziende al momento della valutazione.
È un livello di accesso notevole e molto più profondo di quello disponibile a un normale osservatore esterno, ma contiene un passaggio inevitabile: sono state le aziende a fornire i modelli e ad assicurare che fossero rappresentativi dei propri sistemi più avanzati. Non c’è alcun motivo, sulla base di questa circostanza, per sostenere che abbiano fornito modelli differenti o depotenziati; sarebbe un’affermazione priva di prove. Il punto interessante è un altro: il verificatore indipendente deve comunque affidarsi, almeno in parte, alla collaborazione del verificato.
Lo stesso rapporto di METR rende visibile un secondo limite. Le aziende partecipanti potevano controllare quali informazioni non pubbliche sarebbero state incluse nel rapporto pubblico e, fino a un determinato momento, avrebbero potuto persino abbandonare silenziosamente il processo. METR manteneva l’indipendenza delle proprie valutazioni; il perimetro di ciò che poteva osservare e rendere pubblico dipendeva però anche dagli accordi con i soggetti osservati. Non è una contraddizione: è una dipendenza tecnica e informativa che qualsiasi sistema serio di controllo dovrà affrontare.
Poi serve la potenza di calcolo
Una volta ottenuto l’accesso compare un problema meno visibile: bisogna far funzionare il modello. Valutare un sistema di frontiera non significa necessariamente sottoporgli qualche centinaio di domande e controllare le risposte; significa eseguire grandi quantità di test, ripeterli, costruire ambienti simulati, osservare agenti durante attività prolungate, raccogliere risultati e confrontare comportamenti differenti.
Nel proprio Frontier Risk Report, METR indica anche le condizioni tecniche richieste alle aziende per effettuare alcune valutazioni: almeno quattro milioni di token di input al minuto, un milione di token di output e mille richieste al minuto. Sono numeri che rendono abbastanza bene la distanza fra provare un chatbot e sottoporre un sistema avanzato a una valutazione sistematica.
La domanda diventa allora inevitabile: chi fornisce questa capacità di calcolo? Se la fornisce l’azienda controllata, l’organismo può essere amministrativamente indipendente e contemporaneamente dipendere dal controllato per l’infrastruttura necessaria a svolgere il proprio lavoro. Se invece vogliamo eliminare questa dipendenza, qualcuno deve costruire o finanziare un’infrastruttura alternativa. Stati e organismi sovranazionali dovrebbero quindi disporre non soltanto di giuristi, ispettori e ricercatori, ma anche di hardware, data center, personale tecnico e capacità di calcolo sufficienti per lavorare con sistemi che appartengono alle organizzazioni tecnologicamente più attrezzate del pianeta.
Il controllo dell’intelligenza artificiale comincia così ad assomigliare meno a un’autorità amministrativa e molto più a una seconda infrastruttura tecnologica. È lo stesso rovesciamento che avevamo osservato in Una seconda macchina per usare la prima: quando la complessità dello strumento supera la nostra capacità di seguirlo direttamente, tendiamo a costruire un altro strumento che ci aiuti a governarlo.
Una IA per controllare un’altra IA
A questo punto compare un altro limite, questa volta umano. Anche disponendo dell’accesso e della capacità di calcolo, la quantità di comportamento prodotta durante una valutazione può diventare troppo grande per essere osservata manualmente: occorre cercare anomalie, confrontare migliaia di esecuzioni, individuare strategie inattese e riconoscere schemi che possono emergere soltanto dopo un numero elevato di prove. La soluzione più naturale consiste nell’automatizzare almeno una parte della verifica.
E infatti accade già. Nel rapporto di METR si legge che, durante alcune valutazioni, è stata chiesta alle aziende l’autorizzazione a inviare output e catene di ragionamento del modello verso servizi di IA di terze parti utilizzati, fra le altre cose, per ricerche sul monitoraggio automatico.
La scena può sembrare paradossale soltanto finché la formuliamo in questo modo: utilizziamo un’IA per controllare un’altra IA. In realtà facciamo qualcosa di simile continuamente con i sistemi complessi: utilizziamo software per verificare altro software, strumenti elettronici per verificare circuiti elettronici e computer per analizzare il comportamento di altri computer. Il problema non è quindi l’esistenza dello strumento automatico; comincia un passo dopo.
Come verifichiamo il verificatore?
Se il sistema sa di essere sotto esame
L’AI Security Institute britannico sta studiando proprio il problema del cosiddetto sandbagging: la possibilità che un modello mostri durante una valutazione capacità inferiori a quelle che potrebbe manifestare in altre condizioni.
Non occorre attribuirgli intenzioni umane per comprendere la difficoltà. Se un sistema produce comportamenti differenti in funzione del contesto nel quale opera, il test deve riuscire a distinguere una reale incapacità da una prestazione artificialmente ridotta. AISI ha organizzato persino una sorta di competizione interna: una squadra costruiva modelli capaci di nascondere le proprie prestazioni, mentre un’altra cercava di scoprirli utilizzando diversi metodi di rilevamento.
Il risultato più interessante non è che un’IA possa «fingere», ma che anche il metodo utilizzato per valutarla possiede dei limiti. Più aumentano le capacità del sistema osservato, più sofisticato deve diventare lo strumento di osservazione; più diventa sofisticato lo strumento, più abbiamo bisogno di stabilire quanto possiamo fidarci anche di quello.
Potremmo immaginare una seconda IA incaricata di controllare la prima, poi una terza che controlla la seconda. Continuare non risolverebbe nulla: avremmo soltanto costruito una catena sempre più lunga di sistemi dei quali dobbiamo, a nostra volta, conoscere l’affidabilità. Da qualche parte la catena deve terminare.
Stiamo cercando il controllo nel posto giusto?
Esiste però un elemento che non ragiona, non risponde alle domande, non modifica il proprio comportamento perché viene osservato e non deve essere interpretato linguisticamente: l’hardware.
Nel suo rapporto sulla verifica dei modelli di frontiera, il Scientific Advisory Board delle Nazioni Unite considera proprio la verifica attraverso la capacità di calcolo una delle strade più promettenti. Il motivo è abbastanza intuitivo: l’addestramento e l’esecuzione dei sistemi più grandi richiedono infrastrutture fisiche. Chip, data center, energia e capacità computazionale lasciano tracce più difficili da nascondere rispetto al comportamento osservato durante una conversazione con un modello.
Questo non elimina il problema del controllo, ma lo sposta verso qualcosa che possiamo misurare. Un sistema credibile di verifica potrebbe quindi non chiedere soltanto «che cosa sa fare questa IA?», ma anche quanta capacità di calcolo è stata utilizzata per costruirla, su quale hardware viene eseguita, quali modifiche sono state apportate, quali versioni sono operative, quali accessi sono stati concessi e quali registrazioni permettono di ricostruire ciò che è avvenuto. Il comportamento del modello diventerebbe soltanto uno degli elementi della verifica.
L’indipendenza non è una persona
Possiamo adesso tornare alla proposta iniziale: creiamo un organismo indipendente che controlli i sistemi di intelligenza artificiale più avanzati. Sì. Ma non basta che siano indipendenti le persone che vi lavorano.
Deve essere indipendente il finanziamento; deve essere garantito l’accesso; deve essere verificabile che il sistema osservato corrisponda a quello realmente utilizzato; deve esistere capacità di calcolo sufficiente per effettuare test senza dipendere interamente dall’infrastruttura del produttore. Devono inoltre essere controllabili gli strumenti automatici utilizzati durante la valutazione e devono esistere log, procedure e tracce tecniche che permettano di verificare anche ciò che non può essere osservato direttamente.
L’indipendenza, insomma, non è una caratteristica del controllore: è una caratteristica dell’intera catena del controllo. In La mano sull’interruttore avevamo posto il problema di chi conservi davvero la possibilità di fermare un sistema; qui la stessa domanda si sposta sul livello della verifica: chi conserva il controllo delle condizioni nelle quali il controllo viene esercitato?
È questo il punto che rischiamo di perdere mentre discutiamo su chi debba sorvegliare i grandi laboratori di intelligenza artificiale. Possiamo creare un’autorità esterna, riempirla dei migliori ricercatori disponibili e attribuirle tutti i poteri giuridici necessari; ma se per vedere il sistema deve chiedere al controllato di mostrarglielo, se per eseguirlo deve utilizzare la sua infrastruttura e se per comprenderne il comportamento deve affidarsi a strumenti che devono essere a loro volta verificati, abbiamo spostato il problema senza averlo ancora risolto.
La domanda, allora, non è soltanto chi controlla l’IA. È chi controlla l’accesso, il compute, gli strumenti e le condizioni attraverso cui quel controllo diventa possibile. Perché anche il controllore, prima o poi, deve essere controllato.