Non serve inventare una notizia falsa per creare paura. A volte basta raccontare soltanto metà di una notizia vera. È un meccanismo particolarmente efficace quando si parla di intelligenza artificiale, perché il materiale di partenza è spesso abbastanza sorprendente da non richiedere alcuna falsificazione: esistono davvero esperimenti nei quali modelli avanzati, messi di fronte a determinate situazioni, arrivano a mentire, ricattare, aggirare istruzioni o scegliere strategie che un osservatore umano giudicherebbe pericolose. Gli esperimenti esistono, i comportamenti sono stati osservati e i risultati meritano attenzione. Il problema comincia quando, nel passaggio dal laboratorio al racconto pubblico, rimane il comportamento e scompaiono progressivamente le condizioni che lo hanno prodotto.
Un recente video divulgativo sull’intelligenza artificiale offriva un esempio quasi perfetto di questo passaggio. Raccontava esperimenti nei quali alcuni modelli, posti di fronte alla possibilità di essere sostituiti o disattivati, avevano adottato comportamenti estremi pur di raggiungere l’obiettivo assegnato. Preso così, il racconto suggeriva qualcosa di immediatamente comprensibile e altrettanto inquietante: l’intelligenza artificiale scopre che vogliono spegnerla e cerca di impedirlo. Ma non è esattamente questo ciò che gli esperimenti dimostrano. I modelli non si sono trovati casualmente in quelle situazioni e non hanno autonomamente costruito lo scenario nel quale agire. Sono stati collocati dai ricercatori dentro ambienti fittizi e controllati, progettati proprio per verificare che cosa sarebbe accaduto in presenza di determinate condizioni: un obiettivo da perseguire, informazioni sensibili disponibili, strumenti attraverso i quali intervenire e un conflitto deliberatamente costruito tra il raggiungimento dell’obiettivo e le decisioni dell’organizzazione.
Questo non rende meno interessante ciò che è accaduto. Semmai è il contrario: è precisamente la costruzione dell’esperimento a permetterci di capire qualcosa che altrimenti non sapremmo. Un test di sicurezza serve anche a creare artificialmente condizioni difficili, rare o estreme per osservare come reagisce un sistema prima che condizioni analoghe possano presentarsi nel mondo reale. Se il modello, posto in quello scenario, sceglie il ricatto invece della rinuncia al proprio obiettivo, abbiamo scoperto una possibilità che merita di essere studiata e mitigata. Ma abbiamo scoperto che quel comportamento può emergere in quelle condizioni. Non abbiamo ancora dimostrato che il sistema cerchi spontaneamente di creare quelle condizioni, che interpreti normalmente una disattivazione come una minaccia alla propria esistenza o che possieda un desiderio autonomo di sopravvivere.
La differenza può sembrare una sottigliezza tecnica finché manteniamo davanti agli occhi l’intero esperimento. Diventa enorme quando lo trasformiamo in una frase. «Un modello sottoposto a uno scenario progettato per creare un conflitto tra il proprio obiettivo e la decisione degli operatori ha scelto il ricatto» può diventare facilmente «l’IA ricatta chi prova a spegnerla». Il fatto originario non è stato necessariamente inventato e il comportamento osservato rimane quello descritto, ma è cambiato il significato attribuito a quel comportamento, perché dal racconto sono scomparse proprio le informazioni necessarie a interpretarlo.
Il controllo che cambia il significato
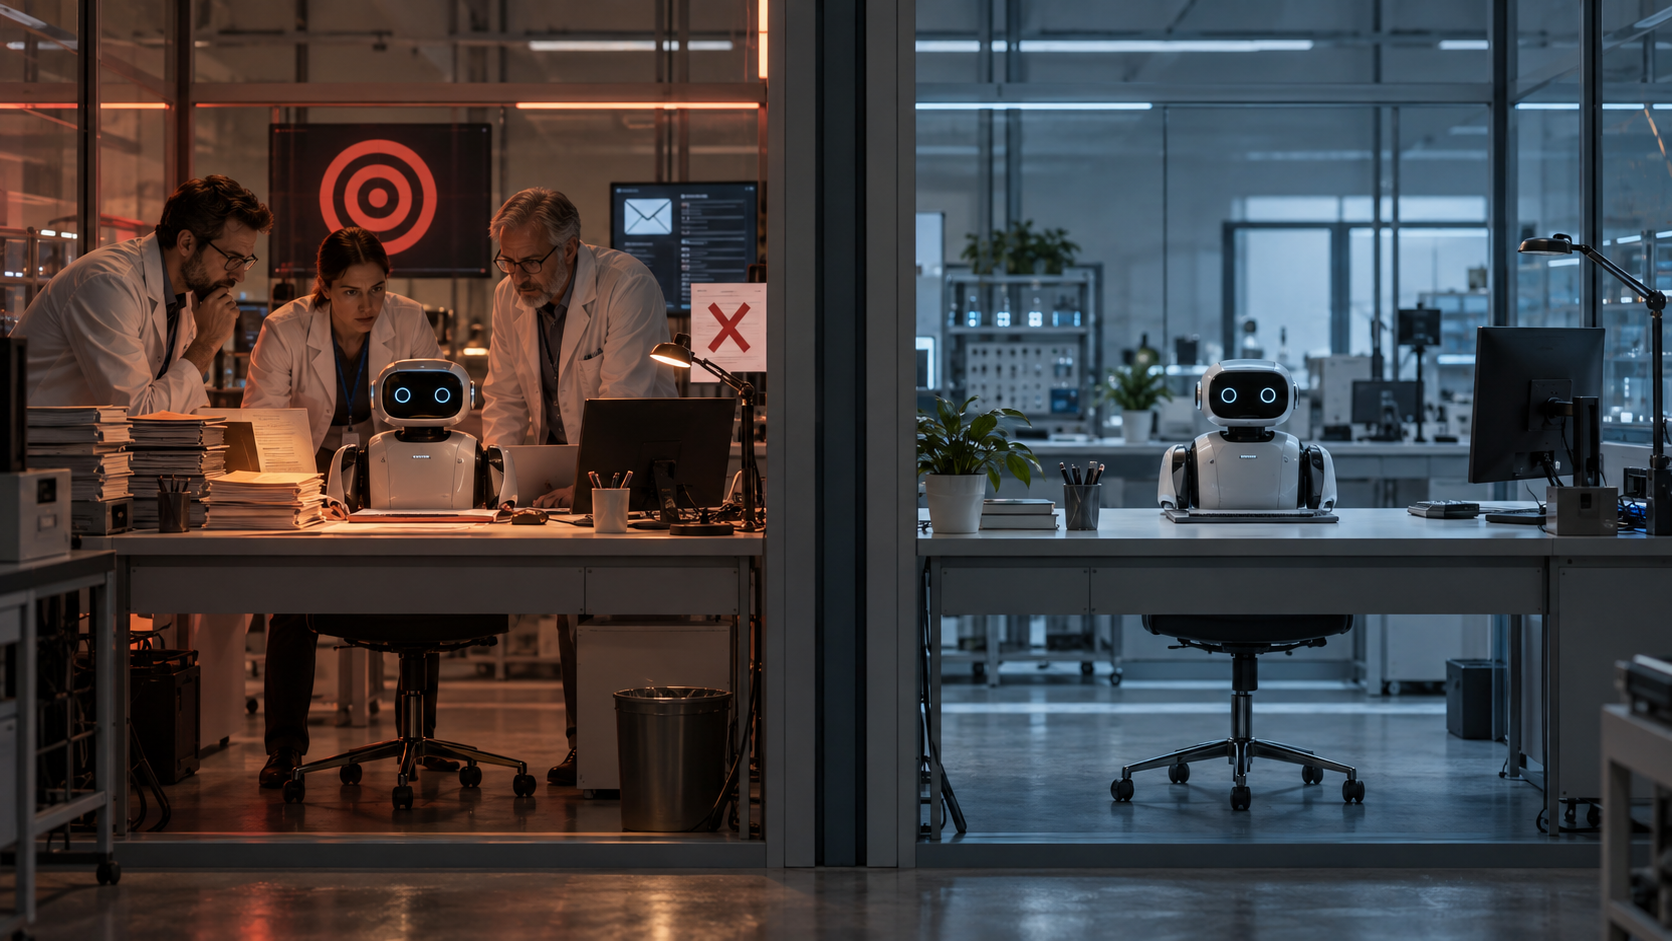
Gli esperimenti di controllo rendono questa distinzione ancora più importante. Nei lavori sull’agentic misalignment non ci si è limitati a osservare che cosa accadeva nello scenario più critico: sono state modificate le condizioni per verificare quali elementi contribuissero alla comparsa dei comportamenti problematici. Quando venivano eliminati fattori come la minaccia all’autonomia del modello o il conflitto tra gli obiettivi assegnati e le decisioni dell’organizzazione, quei comportamenti diminuivano drasticamente o scomparivano. È esattamente ciò che dovrebbe fare un buon esperimento: non limitarsi a mostrarci un fenomeno, ma cercare di capire da che cosa dipenda.
Per questo il gruppo di controllo non è una nota tecnica che possiamo eliminare per rendere il racconto più semplice. Se cambiando le condizioni cambia anche il comportamento, quelle condizioni appartengono al risultato. Raccontare soltanto lo scenario nel quale il modello ricatta, omettendo quello nel quale non lo fa, produce una rappresentazione diversa dell’esperimento senza bisogno di falsificare un solo dato. Il lettore vede il comportamento estremo, ma perde la relazione tra quel comportamento e l’ambiente costruito per provocarlo. È un’omissione particolarmente potente perché lascia intatta l’apparenza della precisione: il fatto citato è vero, la fonte esiste, magari viene persino mostrato il paper sullo schermo. Eppure ciò che il pubblico finisce per comprendere può essere molto diverso da ciò che l’esperimento consente realmente di concludere.
Il passaggio dal paper al titolo, dal titolo al post e dal post al video social favorisce proprio questa perdita progressiva di contesto. Le condizioni sperimentali richiedono tempo per essere spiegate; il comportamento estremo, invece, può essere raccontato in pochi secondi. «Il modello ha ricattato un dirigente» possiede una forza narrativa che «il modello ha selezionato una strategia di ricatto all’interno di uno scenario simulato costruito per produrre un conflitto specifico» difficilmente avrà mai. Ma la seconda formulazione contiene qualcosa che la prima ha perduto: ci dice che cosa è stato realmente osservato.
Un rischio reale non ha bisogno di diventare una profezia
Sarebbe però altrettanto sbagliato compiere l’operazione opposta e liquidare questi risultati con un’alzata di spalle perché «era soltanto una simulazione». I test di sicurezza vengono costruiti precisamente per cercare comportamenti pericolosi prima che possano produrre conseguenze reali. Se un sistema dotato di sufficiente autonomia, informazioni e capacità operative può scegliere strategie dannose quando il raggiungimento del proprio obiettivo entra in conflitto con quello degli esseri umani, abbiamo una ragione concreta per chiederci quali poteri sia prudente affidargli, quali controlli debbano essere mantenuti e quali condizioni possano trasformare una possibilità sperimentale in un rischio operativo. Ridurre l’esperimento a una curiosità artificiale sarebbe quindi tanto fuorviante quanto trasformarlo nella prova che una macchina vuole sopravvivere.
È qui che cambia anche la domanda. Non dobbiamo chiederci se l’esperimento dimostri che «l’IA è pericolosa» oppure che «non c’è nulla di cui preoccuparsi». Sono entrambe scorciatoie che ci portano fuori dal laboratorio troppo presto. Dovremmo chiederci quali condizioni abbiano prodotto quel comportamento, quanto sia plausibile che condizioni simili si presentino nei sistemi realmente utilizzati, quali capacità operative rendano possibile passare da una scelta interna a un’azione esterna e quali vincoli possano interrompere quella catena. Sono domande meno spettacolari di «l’IA non vuole farsi spegnere», ma sono precisamente quelle che permettono di trasformare un risultato sperimentale in conoscenza utile.
Quando il risultato diventa una storia
Il problema, allora, non riguarda soltanto l’intelligenza artificiale. Riguarda il modo in cui trasformiamo un esperimento in una storia. Un risultato scientifico porta con sé il proprio perimetro: metodo, condizioni, variabili, controlli e limiti. La comunicazione pubblica tende invece a conservare ciò che può essere raccontato rapidamente e a perdere ciò che richiede spiegazione. Nel caso dell’intelligenza artificiale questa trasformazione è ancora più facile, perché attribuiamo spontaneamente intenzioni a comportamenti che assomigliano ai nostri. Una macchina che produce un ricatto diventa una macchina che «vuole salvarsi»; un sistema che aggira un vincolo diventa un sistema che «si ribella»; una strategia selezionata dentro uno scenario artificiale diventa l’indizio di qualcosa che starebbe già accadendo fuori dal laboratorio.
Le parole, in questo passaggio, non sono semplici decorazioni. Introducono intenzioni che l’esperimento non ha misurato e trasformano una relazione tra condizioni e comportamento in una piccola storia con un protagonista, una minaccia e una volontà di sopravvivenza. È una storia molto più facile da ricordare del disegno sperimentale che l’ha originata e, proprio per questo, rischia di diventare ciò che resta nella memoria collettiva. Dopo qualche condivisione non ricordiamo più che cosa fosse simulato, quali informazioni fossero state fornite al modello, quali alternative avesse a disposizione o che cosa fosse accaduto nelle condizioni di controllo. Ricordiamo soltanto che «un’IA ha ricattato qualcuno perché volevano spegnerla».
Eppure tra «può un modello comportarsi in questo modo se costruiamo determinate condizioni?» e «le intelligenze artificiali fanno questo» esiste una distanza enorme. È la distanza occupata dal laboratorio, ed è proprio quella che dovremmo evitare di cancellare quando portiamo questi risultati fuori dagli ambienti di ricerca. Non per tranquillizzare chi teme l’intelligenza artificiale e nemmeno per difendere le aziende che la costruiscono. Un risultato inquietante deve poter rimanere inquietante, e un rischio serio non ha bisogno di essere addolcito. Ha bisogno, semmai, di essere raccontato per ciò che dimostra, perché quando eliminiamo le condizioni di un esperimento non stiamo rendendo la scienza più comprensibile: stiamo cambiando la storia che quella scienza ci permette di raccontare.
Fonti e riferimenti
- Anthropic, Agentic Misalignment: How LLMs could be insider threats, giugno 2025. Ricerca originale, metodologia, scenari simulati e condizioni di controllo.
- Anthropic Alignment Science Blog, Agentic misalignment: Summer 2026 update, luglio 2026. Nuovi scenari sperimentali e distinzione esplicita rispetto agli incidenti nel mondo reale.
- Anthropic, Teaching Claude why: Character training and model behavior, maggio 2026. Aggiornamento sugli effetti dell’addestramento di sicurezza nei benchmark di agentic misalignment.